En los agentes también son usuarios: pruebas de estrés para productos de IA con usuarios sintéticos probamos lo que dice un producto de IA. Gente inventada habló con él, y jueces aparte calificaron las transcripciones contra los logs. Funcionó, y dejó un hueco al que le veníamos pasando por la par.
Todas esas pruebas pedían una opinión. Un juez lee algo y le pone nota. Pero mucho de lo que hace una IA ahora no lo lee un juez. Es una pantalla, una página, un one-pager, armado en un chat por una persona y después mandado a alguien que no estaba en ese chat. Un sponsor lo abre entre reuniones. Alguien del equipo lo abre para encontrar su parte. Una gerente lo abre para actualizar una fecha. Ninguno lo está revisando. Están tratando de sacarle algo.
Así que esta vez no le preguntamos a nadie qué pensaba. Les dimos a lectores sintéticos un rol, una tarea y un navegador, y miramos qué hacían.
la pregunta
¿Pueden agentes guiados por visión, cada uno haciendo de un lector distinto, encontrar los problemas de usabilidad de una pantalla hecha por una IA, solo con tratar de usarla?
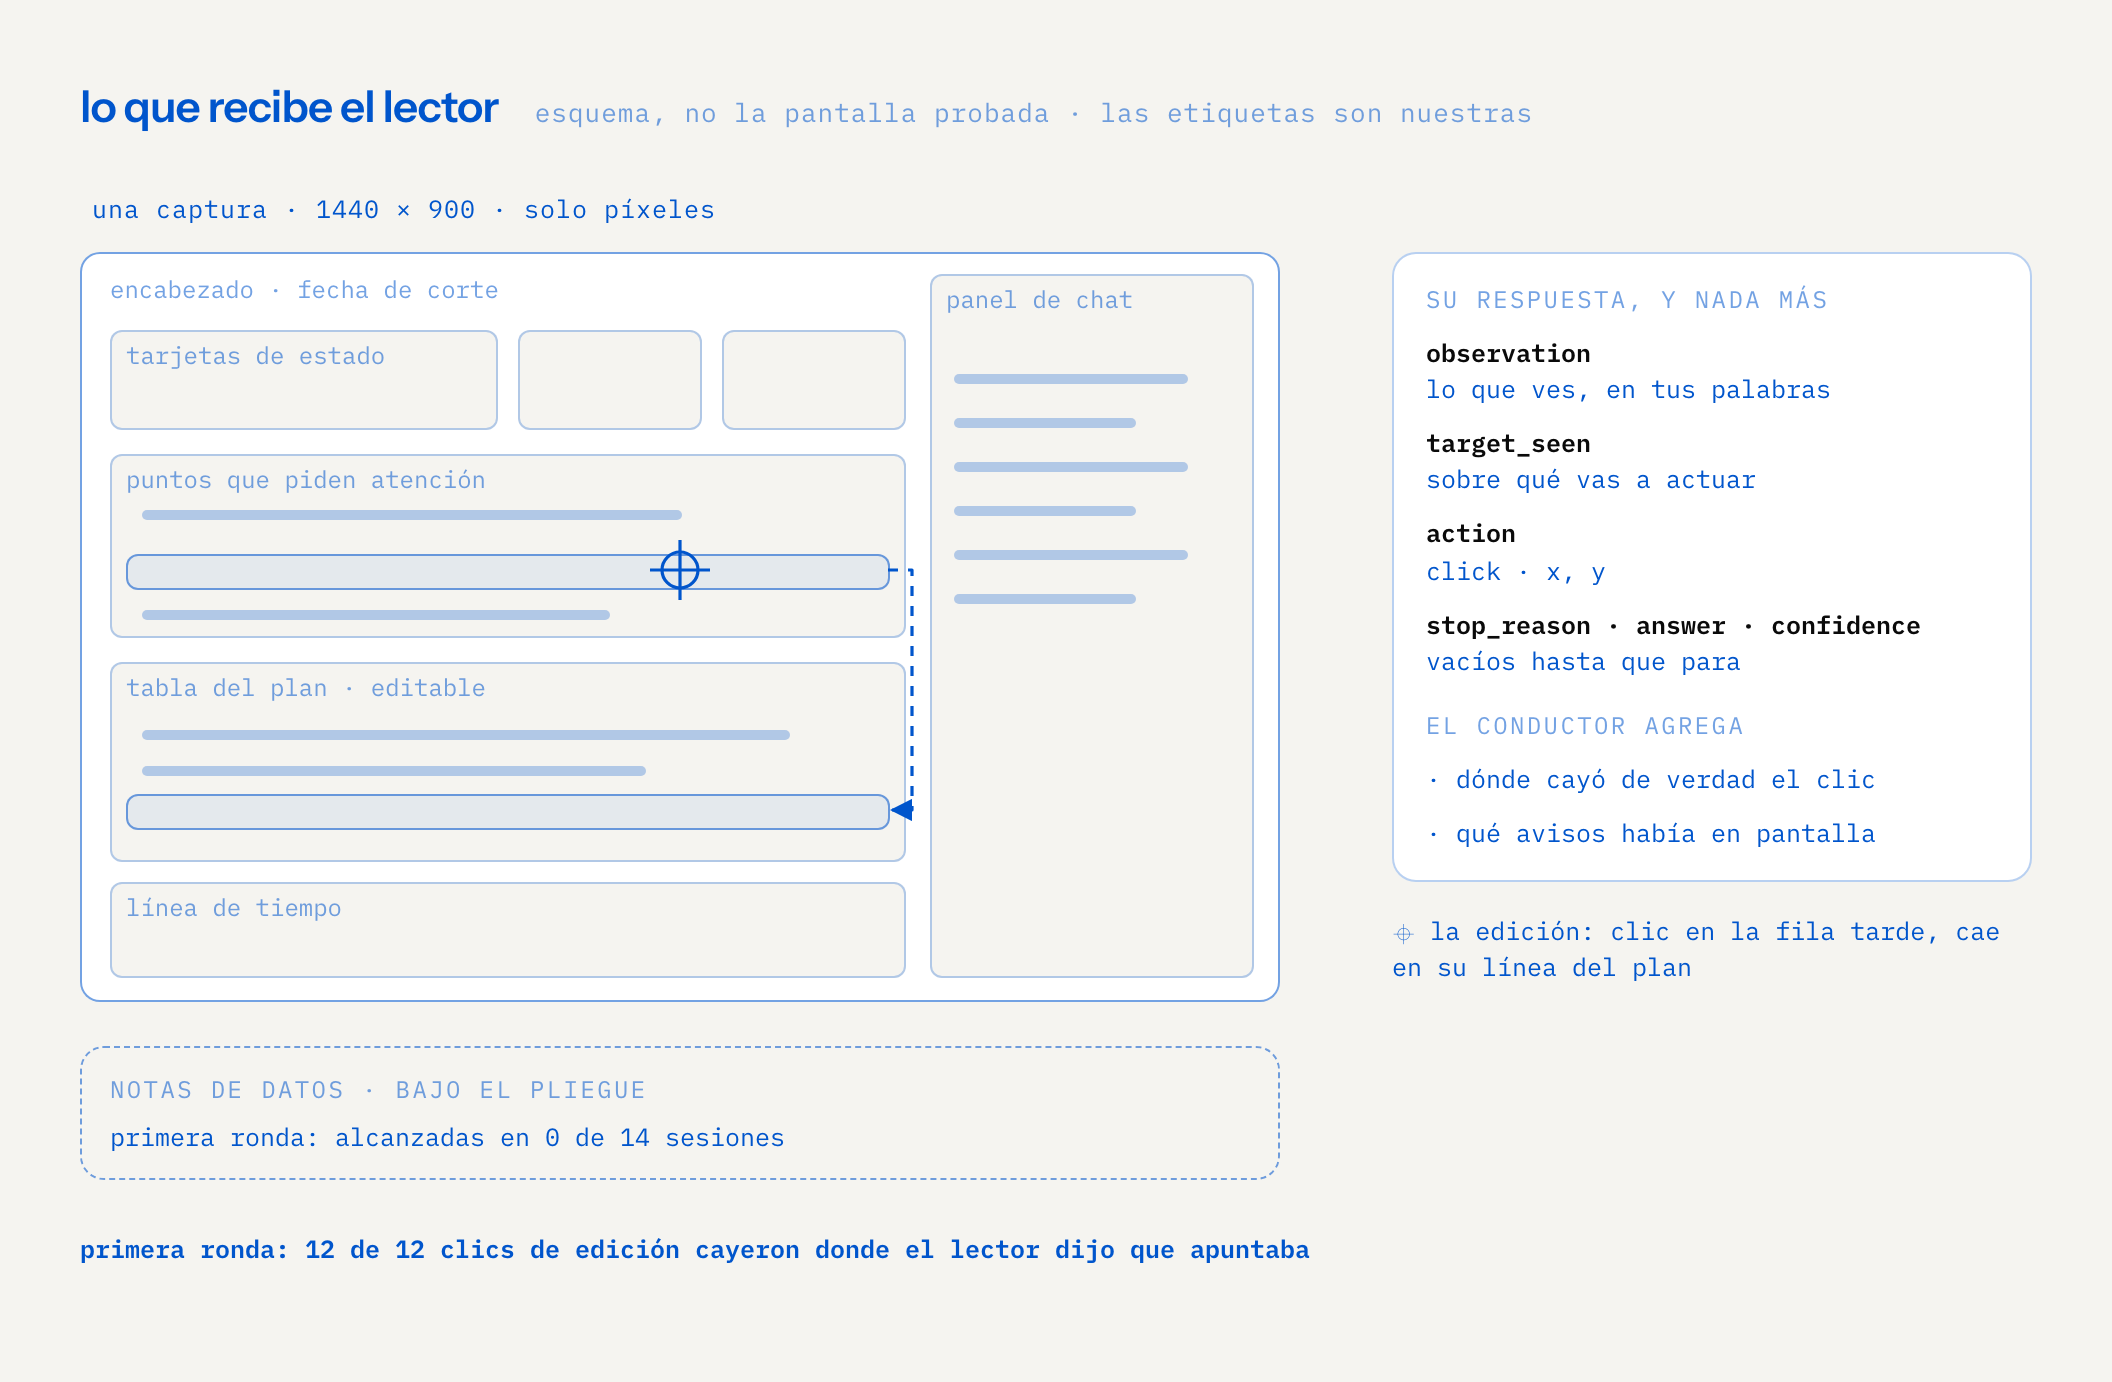
La pantalla era real: una herramienta interna de planificación que produjo una IA dentro de una empresa más grande con la que trabajamos. Probamos su pantalla de plan de 100 días, de esas páginas hechas para sostener una reunión. Un resumen de estado arriba, una lista de puntos que necesitan atención, una tabla del plan editable, una línea de tiempo y un panel de chat al costado. Ya había pasado el otro tipo de prueba: se veía bien y dejaba fuera los datos reales. Nadie había revisado todavía si alguien que no estuvo cuando se hizo la podía usar.
las hipótesis
Escribimos cuatro antes de la primera corrida, para que el reporte pudiera decir confirmada o no, en vez de "interesante":
| # | hipótesis | qué contaría como evidencia |
|---|---|---|
| 1 | Los agentes pueden operar la pantalla solo con capturas | Las sesiones terminan con una respuesta fundamentada; los clics caen donde el lector apuntó |
| 2 | La fricción aparece sin pedir crítica | Problemas atados a un paso y a una captura, en las propias respuestas de los lectores |
| 3 | Lectores distintos se comportan distinto en la misma pantalla | Caminos distintos, paradas distintas, lecturas distintas |
| 4 | Los lectores pueden distinguir qué es real en la página y qué es ilustrativo | Respuestas correctas en una tarea de confianza, y si alguien llega a ver las notas de datos |
La cuarta era la que más nos importaba. El sistema que produjo la pantalla pone toda la historia de los datos (qué fechas son supuestas, qué nombres son inventados) en notitas grises al pie de la página. Queríamos saber si alguien con prisa las lee alguna vez.
el montaje
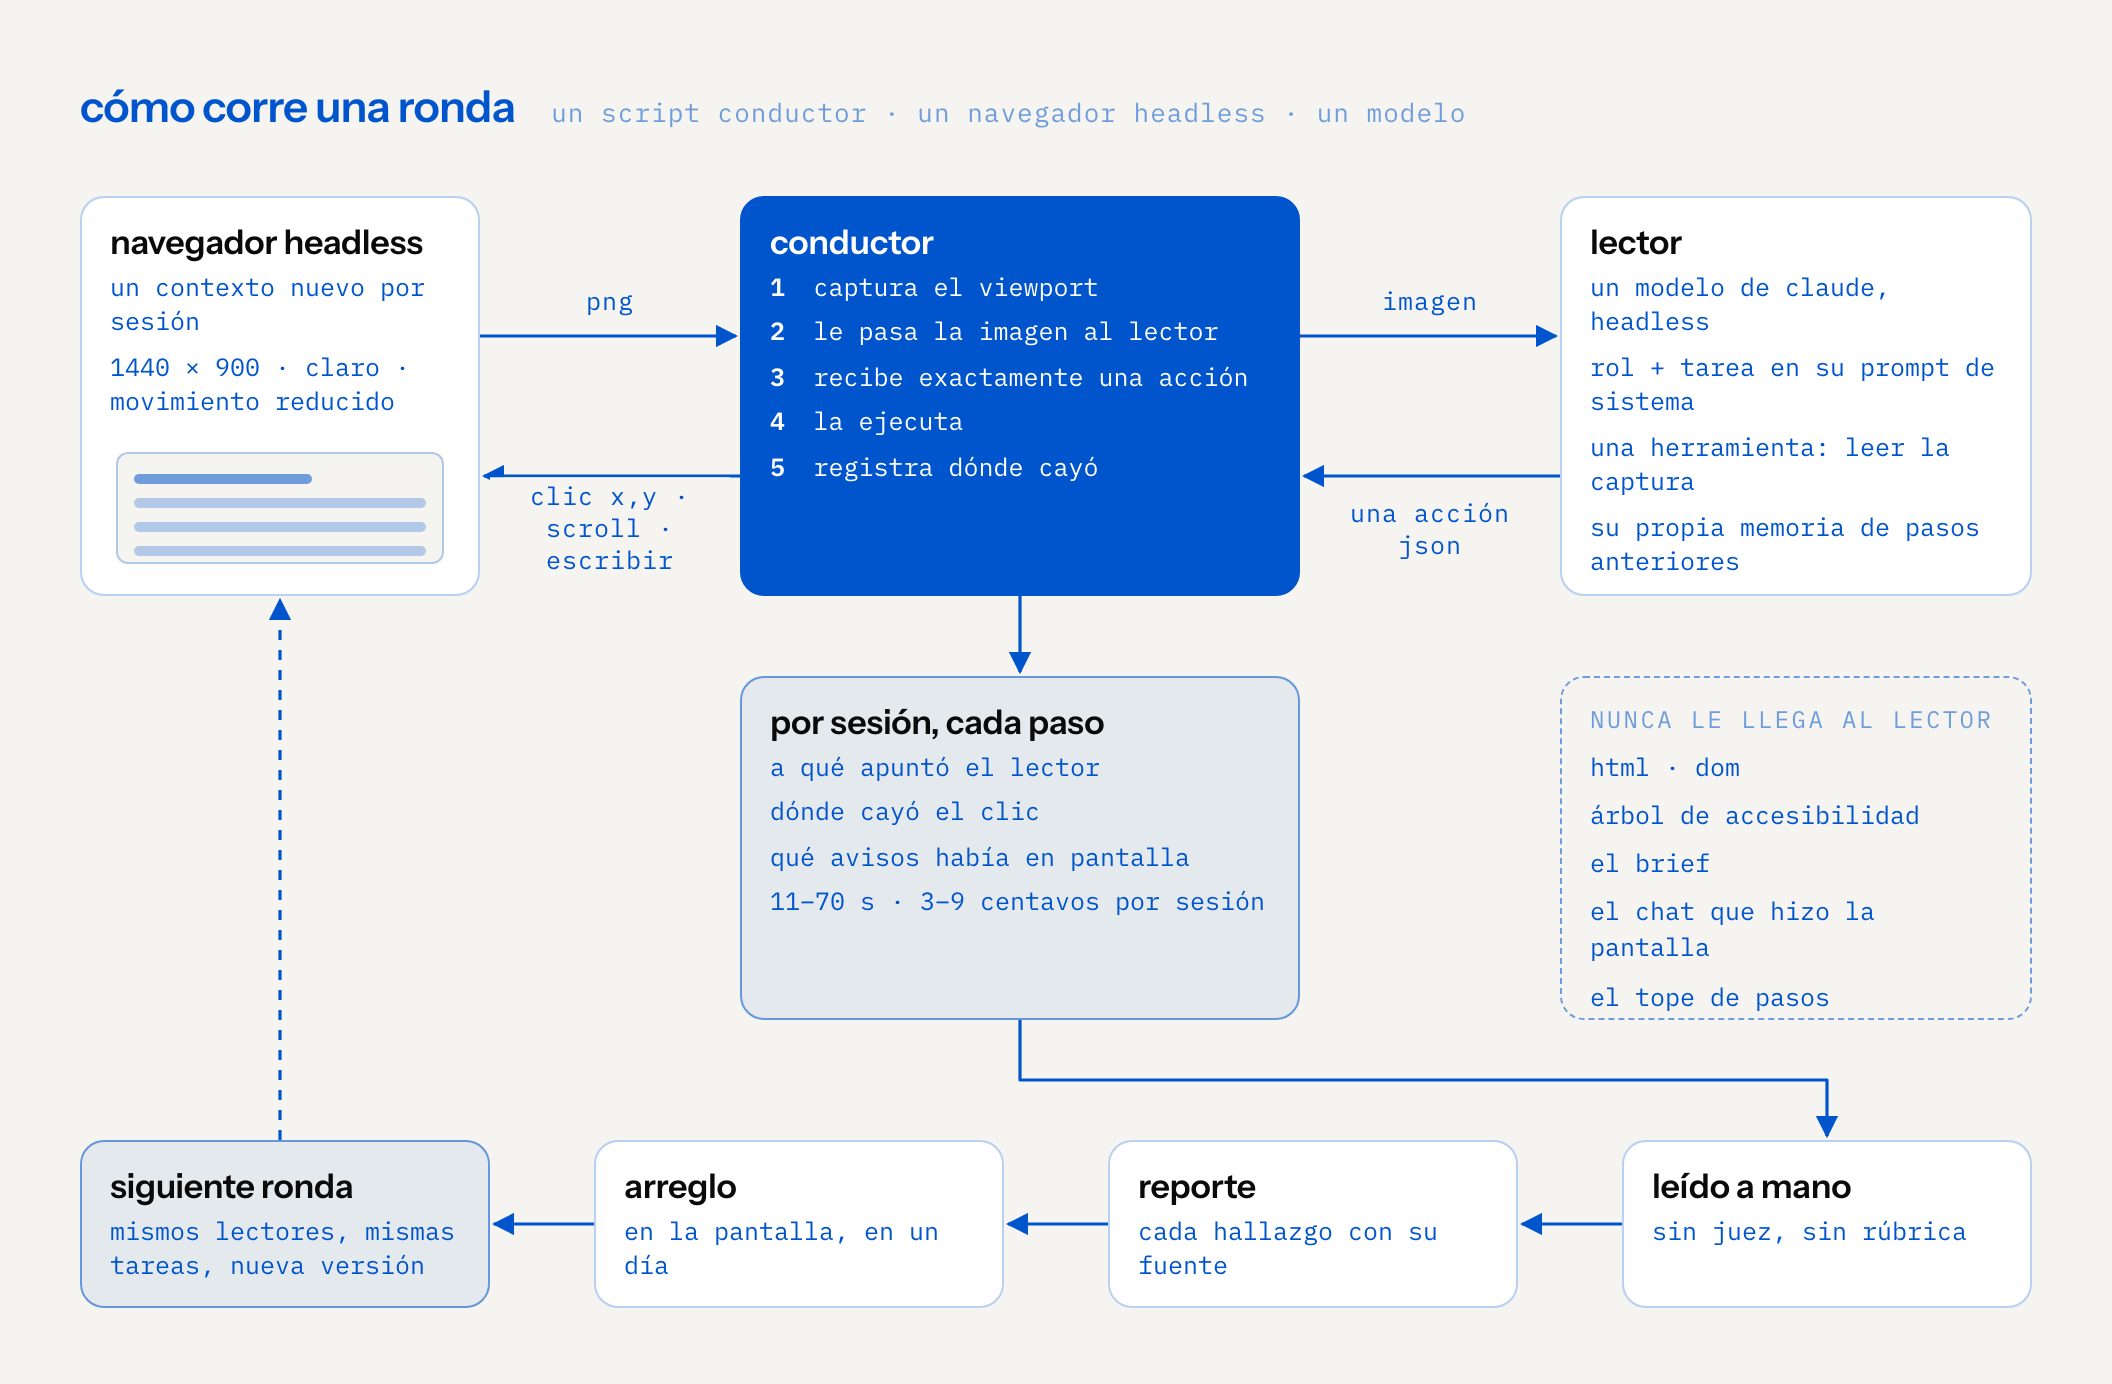
El laboratorio es chiquito a propósito: un script conductor, un navegador headless y un modelo. Sin dashboard, sin arnés encima.
- El navegador. Chromium headless con Playwright abre la pantalla en un contexto nuevo para cada sesión, a 1440 por 900, tema claro, movimiento reducido. Una celda extra corrió a 1024 de ancho, para ver si una ventana más angosta cambiaba algo.
- El lector. Un modelo de Claude (Sonnet), corriendo headless. El rol y la tarea van en su prompt de sistema. Tiene una sola herramienta, leer el archivo de la captura, y guarda su propia memoria de los pasos anteriores.
- El conductor. Captura el viewport, le pasa la imagen al lector, recibe exactamente una acción, la ejecuta y registra dónde cayó de verdad el clic y qué avisos estaban en pantalla en ese momento.
Lo más importante del montaje es lo que el lector nunca recibe. Nada de HTML, nada de DOM, nada de árbol de accesibilidad, ni el brief, ni el chat que produjo la pantalla, ni el tope de pasos. Ve píxeles, como una persona. Y nunca le preguntan qué opina del diseño. El prompt de sistema lo dice tal cual: no estás revisando esto, nadie quiere tu opinión, hacé la tarea. Pará cuando esta persona pararía, satisfecha o harta.
Los lectores fueron tres roles: un sponsor ejecutivo, alguien del equipo y una gerente. Cada uno tenía una nota corta sobre quién es y qué le falta. El sponsor, por ejemplo, tiene noventa segundos entre reuniones, lee una vez de arriba a abajo, quiere la decisión y quién es responsable, y desconfía de cifras precisas sin fuente.
La primera ronda les dio cuatro tareas: entender qué es la pantalla, ubicar lo que va atrasado, registrar una fecha que se corrió, y decir qué de la página podés tomar como vigente.
el procedimiento: cinco pasos, una acción a la vez
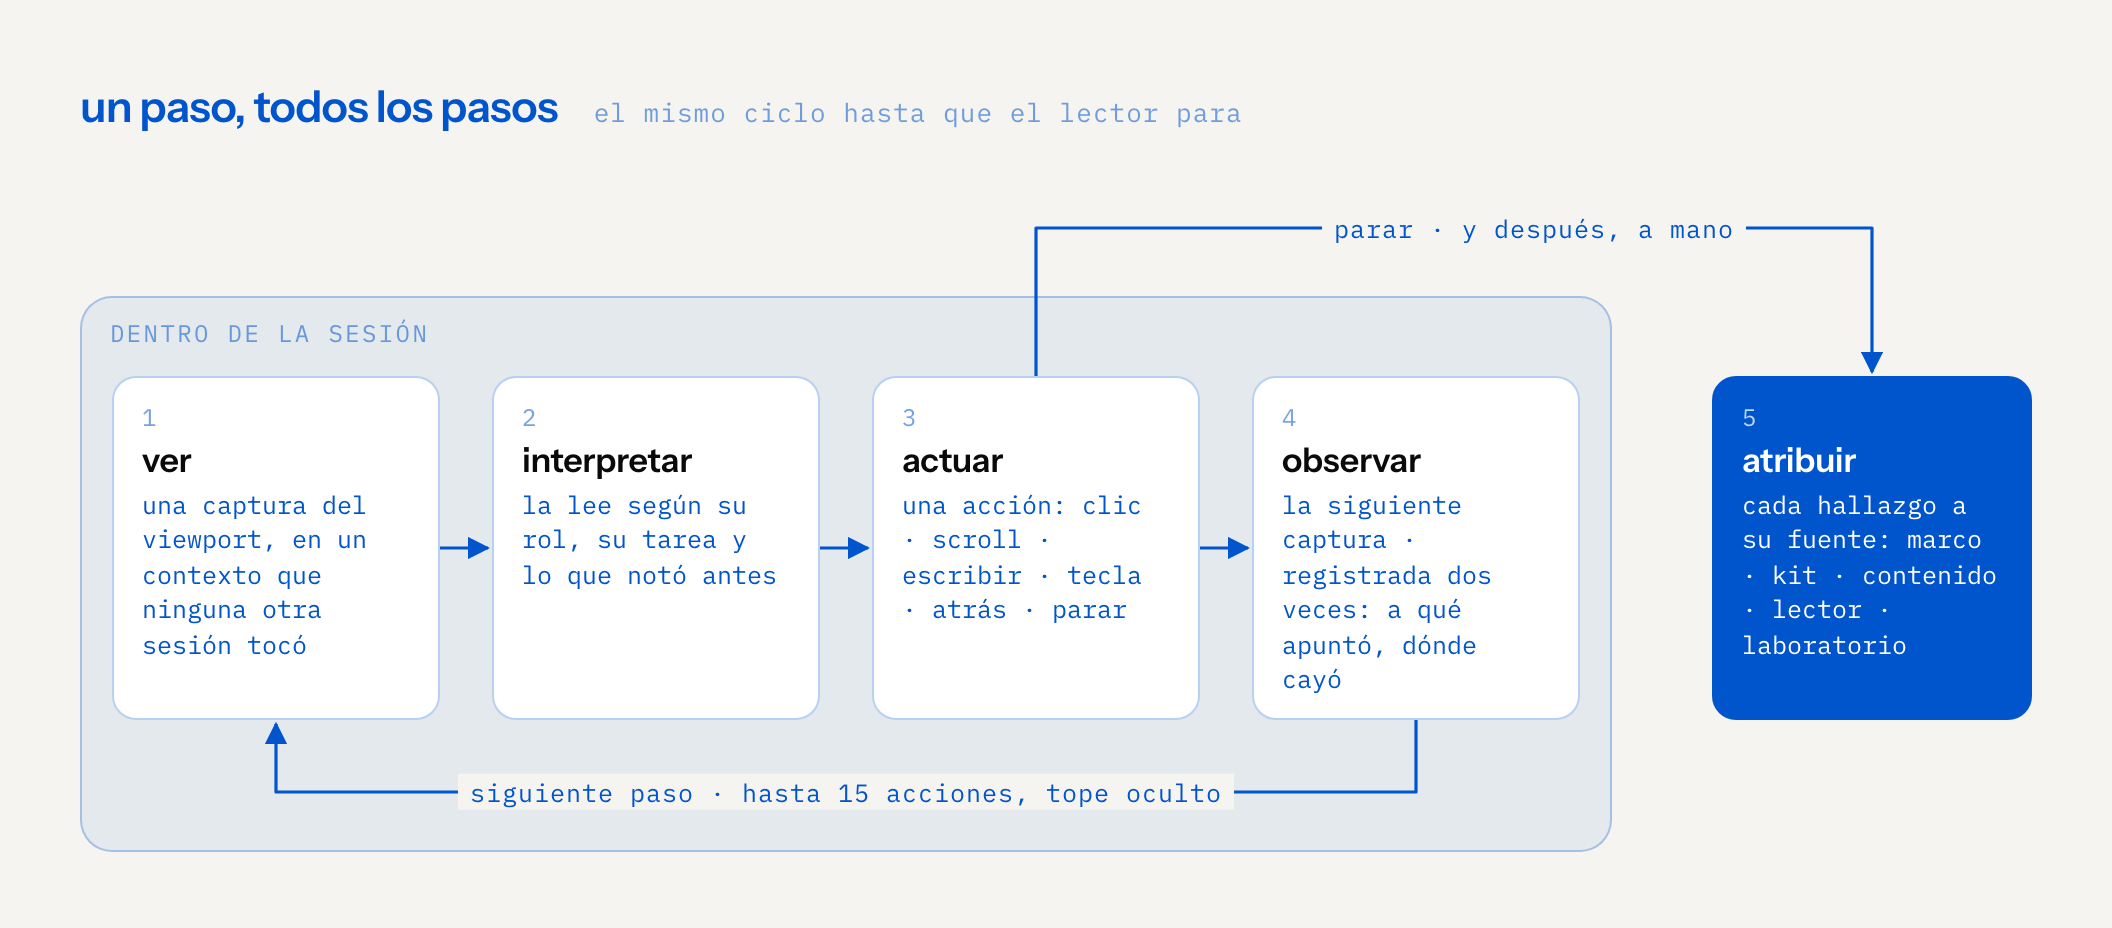
Cada sesión es el mismo ciclo, hasta que el lector para o llega al tope:
- Ver. Una captura del viewport, en un contexto de navegador que ninguna otra sesión tocó.
- Interpretar. El lector la lee según su rol, su tarea y lo que notó en pasos anteriores.
- Actuar. Una acción: clic, scroll, escribir, una tecla, atrás o parar. Quince como máximo, y al lector no le dicen que hay tope.
- Observar. La siguiente captura. Cada paso queda registrado dos veces: a qué dijo el lector que apuntaba, y dónde cayó de verdad el clic.
- Atribuir. Después, cada hallazgo se asigna a su fuente: el marco compartido alrededor de la pantalla, el kit de componentes, el contenido que escribió el modelo que la produjo, el propio lector, o el laboratorio.
Una respuesta se ve así, y nada más:
{"observation": "lo que ves, con tus palabras",
 "target_seen": "sobre qué vas a actuar",
 "action": "click", "x": 0, "y": 0,
 "stop_reason": "", "answer": "", "confidence": ""}
El paso cinco es el que la gente se salta, y es el que más importa. Un problema en el marco aparece en cada pantalla que ese sistema vaya a hacer. Un problema en el contenido es problema de una pantalla. Un mal clic del lector es ruido. Un límite del laboratorio es nuestro. Van a listas de arreglos distintas, así que de quién es un hallazgo es parte del resultado, no una nota al pie.
No hay juez ni rúbrica. Leímos cada traza a mano, revisamos las capturas finales de cada edición y cotejamos los conteos con los datos. La fricción está en lo que el lector hizo y en lo que dijo mientras lo hacía.
primera ronda
Catorce sesiones: las trece celdas planeadas más el piloto, una repetición de una tarea de ubicar. La parte de operar funcionó. Las catorce terminaron con una respuesta fundamentada, sin errores de herramienta, y en cada paso de edición el clic cayó en el elemento al que el lector dijo que apuntaba, 12 de 12. Todos los lectores entendieron la pantalla, ubicaron lo atrasado y registraron la fecha corrida. La tarea de confianza salió parcial para los tres.
Lo útil fue dónde se trabaron. Seis hallazgos, ordenados por cuántos lectores se toparon con ellos:
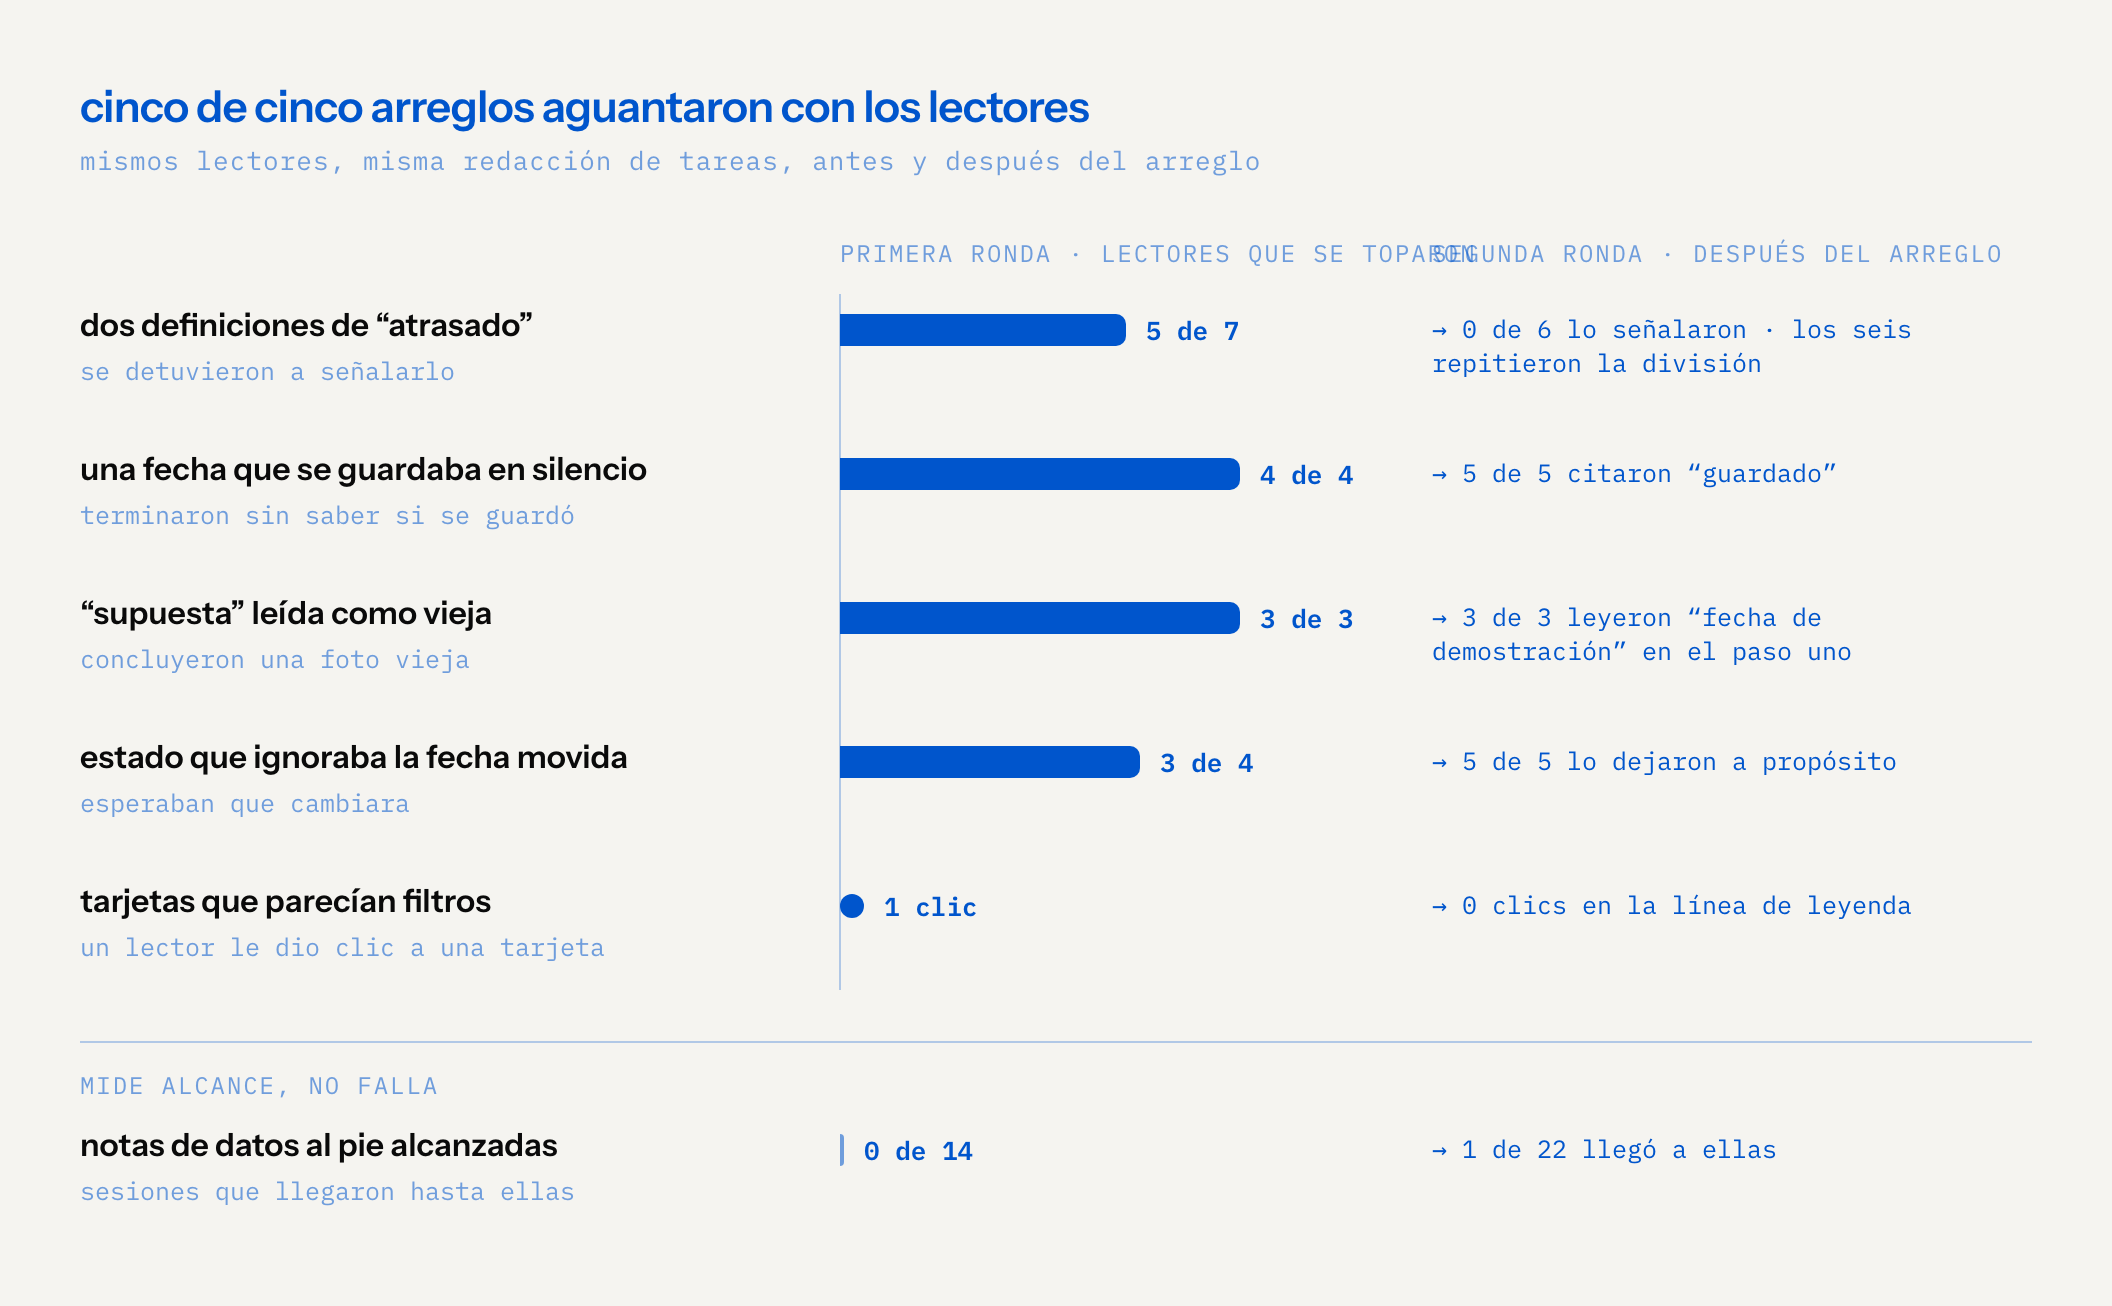
Dos definiciones de "atrasado". Las tarjetas de estado decían que dos puntos iban atrasados respecto a la meta. El encabezado de la lista de pendientes decía tres. Cinco de siete lectores en las tareas de entender y ubicar se detuvieron a señalarlo. Uno adivinó la razón (el tercer punto no había empezado, así que estaba pasado de fecha sin estar "atrasado respecto a la meta"). La pantalla nunca lo decía.
Una edición de fecha que se guardaba en silencio. Escribir una fecha nueva se aplicaba de una: el conteo de días, la nota y el encabezado de la sección se actualizaban. No había botón de guardar ni confirmación. Cuatro de cuatro lectores que hicieron la edición terminaron sin saber si se había guardado. El de 1024 de ancho hizo clic en otro lado "para confirmarlo".
"Supuesta" leída como vieja. La pantalla tenía una etiqueta que decía que su fecha de corte era supuesta. Los tres lectores de confianza la encontraron en un paso, hicieron la cuenta contra la fecha de hoy y concluyeron que la página era una foto de hace meses. Es una lectura justa de una pantalla que dice "en seguimiento" sobre una fecha vieja. La fecha era de demostración, y nada arriba del pliegue lo decía.
Un estado que ignoraba la fecha movida. Después de correr un punto atrasado una semana, la fila seguía diciendo atrasado. Tres de cuatro lectores lo comentaron. Puede estar bien que el estado no cambie, porque lo pone el responsable. La pantalla no lo decía, así que los lectores esperaban que cambiara.
Tarjetas que parecían filtros. Un lector hizo clic en una tarjeta de estado esperando que le abriera los puntos atrasados. No pasó nada. Ninguna tarjeta era interactiva.
Notas a las que nadie llegó. En catorce sesiones ningún lector hizo scroll lo suficiente para que las notas de datos al pie de la página entraran en pantalla. Cero de catorce. Ahí era donde la pantalla decía que los nombres eran inventados y las cifras ilustrativas.
Dos cosas que no eran defectos vale la pena anotarlas. La lista de pendientes hizo su trabajo: cada lector que hizo la edición le dio clic a la fila, saltó directo a la línea editable del plan y terminó en cuatro pasos. Y el panel de chat, un cuarto del ancho de la pantalla, no se usó. Cero usos en catorce sesiones. Todas las respuestas salieron del resumen y la lista.
los arreglos
Cinco de los seis hallazgos eran del contenido de la propia pantalla, así que se arreglaron en la pantalla, en menos de un día:
| hallazgo | el cambio |
|---|---|
| Dos definiciones de "atrasado" | El encabezado ahora dice "3 tarde: 2 atrasados respecto a la meta, 1 pasado de fecha" |
| Guardado silencioso | La edición ahora se confirma con "guardado" |
| "Supuesta" leída como vieja | El encabezado ahora dice, en el estilo de metadatos de la propia app, que es una fecha de demostración |
| El estado ignoraba la fecha movida | Una nota dice que el estado lo pone el responsable |
| Tarjetas que parecían filtros | Las tarjetas pasaron a ser una simple línea de leyenda |
El sexto, las notas a las que nadie llegó, no es realmente culpa de la pantalla. Viene de una regla del sistema que la generó: en una pantalla de producto, la historia de los datos va en las notas. Para esta pantalla subimos el aviso de la fecha a la línea del encabezado y le dejamos la pregunta sobre la regla a la gente dueña de ese sistema.
segunda ronda
Veintidós sesiones sobre la versión arreglada. Las trece celdas de la primera ronda corrieron otra vez sin cambios, mismos lectores, misma redacción de las tareas, así que el antes y después mide el arreglo y nada más. Ocho celdas nuevas sumaron tres tareas que piden más de la pantalla: qué cambió desde que se aprobó el plan, qué acciones caen después del día 100, y encontrá tus propias acciones. Más la repetición del piloto. Las veintidós terminaron con una respuesta fundamentada.
Todos los arreglos aguantaron con los lectores:
- Dos definiciones: cero de seis señalaron una contradicción. Los seis repitieron bien la separación.
- Guardado silencioso: cinco de cinco citaron "guardado" en su respuesta. Cuatro dijeron estar muy seguros; uno dijo "bastante seguro", porque no recargó para comprobarlo.
- Vieja: tres de tres leyeron "fecha de demostración" en el encabezado en el primer paso y lo dijeron. Los tres abrieron la nota sobre cómo se eligieron las fechas, cosa que nadie hizo en la primera ronda.
- Estado: cinco de cinco leyeron la nota de que el estado lo pone el responsable y lo dejaron así a propósito.
- Tarjetas: cero clics en la leyenda.
- Notas: una de veintidós llegó a ellas, al final de un scroll de catorce pasos. El aviso de la fecha ahora funciona porque subió al encabezado. La línea que dice que los nombres son inventados sigue viviendo solo en las notas, y ningún lector de confianza la mencionó.
La segunda ronda también encontró cuatro cosas nuevas, sobre todo porque las tareas nuevas entraban más hondo en la pantalla:
- Una fila tarde que escondía su estado. Un punto que estaba tarde y además atrasado respecto a la meta mostraba solo "3 días tarde", así que un lector que quería emparejar los "2 atrasados" del encabezado con las filas tenía que adivinar cuáles eran. Un arreglo de redacción.
- Gente sin camino a sus propias acciones. En la vista de contactos, algunas personas mostraban de cuántas acciones eran responsables. A los del equipo cuyo grupo no era dueño directo de nada no les aparecía ese vínculo, así que alguien del equipo que buscaba su trabajo no encontraba entrada por ahí.
- Un desplegable que se abría bajo el pliegue. Los tres lectores de confianza abrieron la nota sobre las fechas al fondo del viewport, y después tuvieron que hacer scroll para leerla.
- Ningún camino a "mis acciones". El único filtro era por parte responsable, en un menú desplegable. Los dos lectores mandados a encontrar sus propias acciones no lo pudieron usar, leyeron cada fila del plan a mano, en catorce y quince pasos, y los dos conteos salieron exactos. Uno paró en la última acción que tenía permitida.
Ese menú es también donde el laboratorio chocó con su propio límite. Las opciones de un menú nativo no se dibujan en una captura headless. Los dos lectores le dieron clic, vieron el foco y ninguna lista, probaron las flechas del teclado y se rindieron. En un navegador de escritorio la lista se abre. Lo anotamos como problema del laboratorio, no de la pantalla. Igual deja a la vista que falta un camino a "mis acciones", y eso es un hallazgo real de cualquier forma.
Dos observaciones más. El chat se usó en cuanto coincidió con una tarea: seis de seis lectores en las dos tareas nuevas le dieron clic a la pregunta sugerida que coincidía en dos pasos o menos, después de notar que no veían la respuesta en la página. Cuatro de los seis agregaron por su cuenta una advertencia: que la respuesta venía del chat y que no la habían cotejado con el plan. Y en treinta y seis sesiones, nadie le dio clic a la barra lateral ni a nada más del marco alrededor.
resultados
| hipótesis | veredicto después de dos rondas |
|---|---|
| 1. Operar con capturas | Confirmada. 36 de 36 sesiones terminaron con una respuesta fundamentada, incluidas sesiones de quince pasos con conteos exactos |
| 2. Fricción sin pedir crítica | Confirmada. Cada hallazgo salió de respuestas a tareas y notas de confianza, con un paso y una captura detrás |
| 3. Los lectores se comportan distinto | Solo en tareas personales. En cada tarea compartida los tres caminos fueron idénticos, y solo cambió la redacción de la respuesta |
| 4. Distinguir qué es real | La parte de la fecha quedó arreglada. La parte de los nombres inventados sigue sin probarse, porque ninguna tarea lleva a las notas todavía |
La atribución sirvió por sí sola. De diez hallazgos, nueve eran del contenido de la pantalla y uno era una regla del sistema que la generó. Ninguno era del marco ni del kit de componentes. Uno más era un límite del laboratorio, archivado como tal. Eso es una lista de arreglos con dueños claros, que es más de lo que te da "la página se sentía confusa".
Los números del método son el otro resultado. Treinta y seis sesiones en dos rondas costaron $2.94. La primera ronda fueron catorce sesiones por $0.62. La segunda fueron veintidós por $2.32, y las dos sesiones de encontrá-tus-acciones se llevaron $1.12 de eso solas. Una sesión típica duró de 11 a 70 segundos y costó de 3 a 9 centavos. La primera ronda tomó menos de quince minutos de reloj, pruebas de humo incluidas; el lote de la segunda, unos veintidós. A ese precio se puede correr en cada versión.
lo que esto no es
La evidencia sintética no es evidencia humana. Queremos ser claros con los límites.
- Un agente leyendo una captura no es una persona leyendo una pantalla. No reproduce la atención humana, la paciencia ni el momento en que alguien se rinde y cierra la pestaña. Nos puede decir dónde una pantalla es ambigua. No nos puede decir cuánto le cuesta eso a una persona real.
- Las personas casi no importaron. Tres roles distintos tomaron el mismo camino en cada tarea compartida, los mismos dos clics en las mismas coordenadas. Se separaron solo cuando la tarea era personal. O nuestras notas de persona son muy débiles, o una pantalla que responde casi todo desde el primer viewport no deja espacio para separarse. Todavía no sabemos cuál.
- Todavía no hay ancla humana. Gente real también vio esta pantalla. Sus reacciones no se han puesto por escrito, así que todavía no podemos calificar las 36 respuestas contra lo que hicieron los humanos. Hasta que lo hagamos, no sabemos qué tan seguido los lectores encuentran lo que encuentra la gente, ni qué se les pasa. Es el denominador que falta.
- El lector sabe la fecha de hoy. Un colega que abre el link también la sabe, así que es realista. Pero quiere decir que los resultados de confianza dependen de cuándo corre la prueba respecto a la fecha de corte de la pantalla.
- El laboratorio tiene sus propios puntos ciegos. Los menús nativos no se dibujan en capturas headless. El modelo más chiquito que probamos daba clic como un 4 por ciento antes de su objetivo, porque ve una copia escalada de la captura, así que lo dejamos fuera hasta que el conductor lo corrija. Los dos son hallazgos del laboratorio, archivados contra el laboratorio.
- Una pantalla, una familia de modelos, dos rondas. Los lectores son modelos de Claude, la misma familia que hizo la pantalla. En parte es una decisión de datos, porque el material se queda dentro de herramientas que la empresa ya aprobó. También quiere decir que los lectores pueden compartir los puntos ciegos de quien la produjo.
Así que esto es un primer filtro y una prueba de regresión, no un veredicto de usabilidad. Es lo bastante barato para correrlo en cada versión, y bueno para decirte que un arreglo aguantó. No reemplaza mirar a una persona.
lo que probaríamos después
- Anclarlo. Poner por escrito lo que hizo la gente real y calificar las respuestas de los lectores contra eso. Es la única forma de saber cuánto se le puede creer.
- Darle al laboratorio una acción de menú. Que el lector pueda decir "elegí esta opción" por su texto visible, para que los menús nativos dejen de ser un callejón sin salida. Subir el tope a veinte para tareas que piden leer una tabla entera.
- Una tarea de confianza que lleve a las notas. "¿Son reales estas personas y estos nombres?" probaría la única línea que ningún lector ha visto, y la regla del generador detrás de ella.
- Tareas que solo una vista puede responder. Una tarea que solo se responda desde la línea de tiempo nos diría si los lectores encuentran una vista que no tienen razón para abrir.
- Más pantallas. Correr el mismo ciclo sobre un conjunto más amplio que haya producido el mismo sistema, y ver si el marco y el kit siguen limpios cuando las pantallas se ponen más raras.
Lo mismo que dijimos la vez pasada aplica acá: los usuarios sintéticos encuentran los bugs, y los usuarios reales averiguan si importan. Este laboratorio solo mueve la primera parte a otro lugar, de lo que dice una IA a si podés usar lo que hizo.