Todo proceso de diseño centrado en las personas empieza igual en la pizarra: investigar, después definir, después hacer. Y todo estudio pequeño sabe cuál de los tres se aprieta cuando el presupuesto es real. No podés recortar el hacer. Rara vez podés recortar el definir. Así que la investigación se vuelve un día viendo competidores, unos cuantos screenshots en un frame de Figma, y una frase en la propuesta que dice "informado por."
Eso no es una falla moral. La investigación es lenta por naturaleza. Recolectar es lento, transcribir es lento, etiquetar es lento, contar es lento. La mayoría de las horas de una fase de investigación como se debe son mecánicas — y en una factura, las horas mecánicas cuestan lo mismo que las creativas.
En el último año eso dejó de ser cierto para nosotros. Cambió cuánta investigación hacemos, no solo qué tan rápido.
la mitad mecánica
Tomá un estudio que hicimos este mes. Queríamos entender un formato de video corto antes de hacer el nuestro. La versión honesta de ese estudio es: conseguir los treinta ejemplos más recientes, transcribir los treinta, cortar cada uno en frames, cronometrar cada beat, registrar el hook, el llamado a la acción, la duración, los números — y después buscar el patrón.
Hace cinco años eso es una semana para un junior y una hoja de cálculo que nadie vuelve a abrir. Nosotros lo hicimos en un día y medio. No porque alguien trabajara más rápido — porque recolectar, transcribir y llenar los registros se fue a agentes, y el tiempo de la persona se fue a las dos partes que importan: decidir qué mirar, y leer lo que volvía.
La misma forma sigue apareciendo. Medir qué es lo que de verdad destacan los curadores en una plataforma de portafolios antes de construir un caso de estudio, en vez de adivinar. Leer un año de campañas de email de un cliente para encontrar cuál hizo el dinero, antes de proponer una nueva. Auditar cada canal de una comunidad antes de sugerir cómo manejarla.
Ninguna de estas es una idea nueva. Son los estudios que siempre quisimos hacer y que rara vez podíamos justificar.
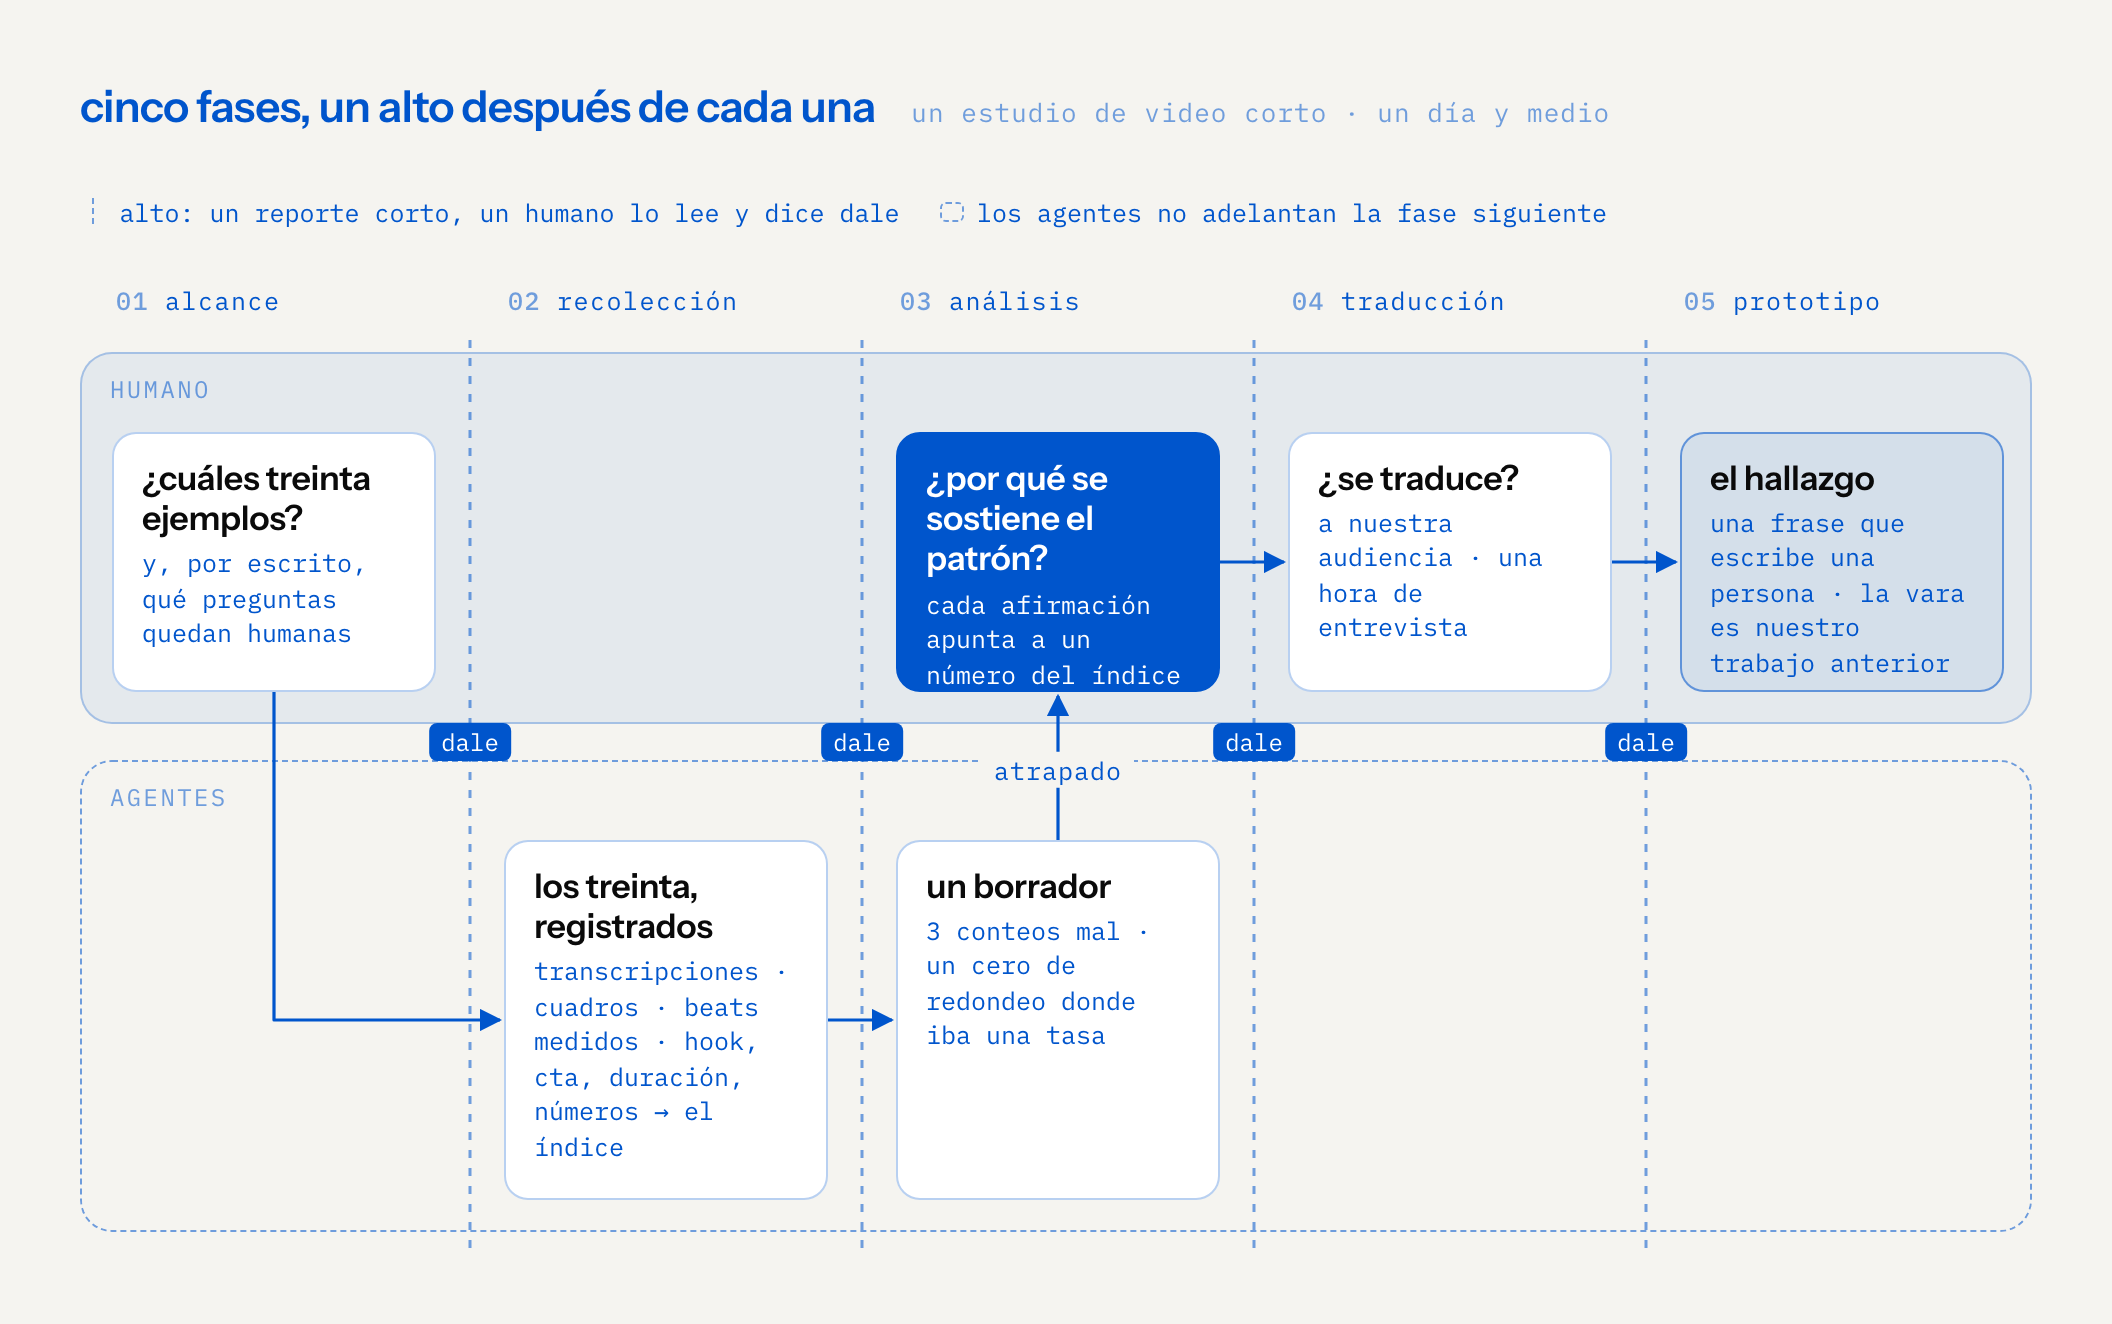
lo que exigimos
La investigación barata es fácil de hacer mal. Cuatro cosas, no negociables.
Fases, con puntos de control. Corremos la investigación en fases explícitas — alcance, recolección, análisis, traducción, prototipo. Cada fase termina con un reporte corto y un alto. Un humano lo lee y dice dale. Los agentes no adelantan trabajo de la siguiente fase. Esto suena burocrático y es lo contrario: es la única forma de atrapar un supuesto equivocado en la fase uno antes de que se haya multiplicado a lo largo de la fase tres.
Verificá el análisis contra los datos. Cuando un agente redactó nuestro estudio de video, tres de los conteos del borrador estaban mal, y un error de redondeo había producido un cero donde debía haber una tasa. Los atrapamos porque cada afirmación del documento tenía que apuntar a un número en el índice. Un análisis que no podés rastrear hasta sus registros es una opinión con una tabla encima.
Referencia no es benchmark. Los treinta ejemplos que estudiamos eran el modelo, no la vara. La vara era nuestro propio trabajo anterior, con sus propios números. Es fácil, una vez que mediste algo impresionante, empezar a juzgarte contra eso. La comparación correcta sos vos, antes y después.
Delegá lo mecánico, quedate con el juicio. "Cuáles treinta ejemplos" es una pregunta humana. "Por qué se sostiene este patrón" es una pregunta humana. "Si esto se traduce a nuestra audiencia" es una pregunta humana — y responderla tomó una hora de alguien siendo entrevistado. Transcribir no es una pregunta humana. Cronometrar beats tampoco. Esa línea la trazamos por escrito, en el brief que arranca el estudio, antes de que corra nada.
lo que cambia
El cambio obvio: la fase de investigación existe otra vez. Está en la propuesta como horas y no como una frase.
El cambio menos obvio es lo que nos podemos dar el lujo de preguntar. Cuando medir cuesta una semana, medís una vez, al principio, y medís lo grande. Cuando cuesta una tarde, podés medir antes de una decisión en vez de después. Cuál miniatura. Cuál duración. Si lo que creés de tu audiencia sigue siendo cierto este mes. Preguntas pequeñas que antes se resolvían a favor de quien argumentaba mejor en el cuarto.
Eso está más cerca de lo que se suponía que era el diseño centrado en las personas. No un ritual al inicio del proyecto — un hábito de chequear.
la trampa
- Los agentes producen el material, no el hallazgo. En cada estudio hasta ahora, la frase que importó — la que cambió lo que construimos — la escribió una persona después de leer el material, y casi siempre era una frase que el material no decía en voz alta. "Gana la voz de la casa." "Producimos de más." "Nuestras palabras están en el campo equivocado."
- La recolección barata también abarata las malas preguntas. Ahora podés medir lo equivocado treinta veces antes del almuerzo. La conversación de alcance se volvió más importante, no menos.
- Un punto de control que no leés de verdad es solo un retraso. Los reportes de fase solo funcionan si alguien los lee antes de decir dale. Hemos dicho dale sin leer. Nos costó una fase.