Ya escribimos sobre dejar que la IA te entreviste: le pasás el material y hacés que te pregunte una cosa a la vez, cada una con una respuesta recomendada, hasta que las decisiones de verdad estén tomadas. Esa nota está construida sobre el skill /grill-me de Matt Pocock. Esta es su hermana. La misma jugada, apuntada al revés: hacé que el modelo se interrogue a sí mismo.
el plan que te devuelve
Preguntale a un modelo cómo construiría algo y te devuelve un plan. Casi siempre es ordenado, y casi siempre es complaciente. Responde la pregunta que hiciste, en la forma en que la hiciste, y carga una capa de supuestos que nadie escribió: para quién es la cosa, qué ya existe, qué significa "terminado", qué restricción decidió en silencio que no importaba.
El otro hábito es el menú. Tres opciones, una tablita de pros y contras, "depende de tus prioridades." Parece generoso. Te devuelve la parte más difícil del trabajo justo cuando tenés menos con qué decidir.
Ninguna de las dos es una mala respuesta. Las dos son primeros borradores que el modelo nunca cuestionó antes de entregarlos.
que se interrogue a sí mismo
Así que antes de construir nada, le pedimos al modelo que se entreviste a sí mismo sobre su propio plan. Las reglas son las mismas de la entrevista, vueltas hacia adentro:
- Una pregunta a la vez. Una difícil, sobre el plan mismo, escrita después de la última respuesta.
- Cada una con su respuesta recomendada. No "depende." Qué haría, y por qué.
- Argumentar en contra. La versión más fuerte de por qué este plan es el equivocado, escrita como si otra persona tuviera que defenderlo.
- Nombrar los supuestos. Lo que de otra forma usaría de base sin decirlo, como una lista simple.
- Buscar mejores rutas. Si otro enfoque le gana al que propuso, que lo diga, aunque eso signifique botar la primera respuesta.
- Después elegir una. Una ruta, y la razón. Nada de menú.
Las preguntas son las que haría alguien que revisa con cuidado. ¿Qué haría que este plan esté mal? ¿Qué estoy suponiendo sobre la persona que lo va a usar? ¿Cuál es la versión más chica que nos diría si esto funciona? Si esto falla, ¿cuál es la razón más probable? Ninguna es ingeniosa. El punto es que el modelo se las hace a sí mismo, en orden, antes que vos.
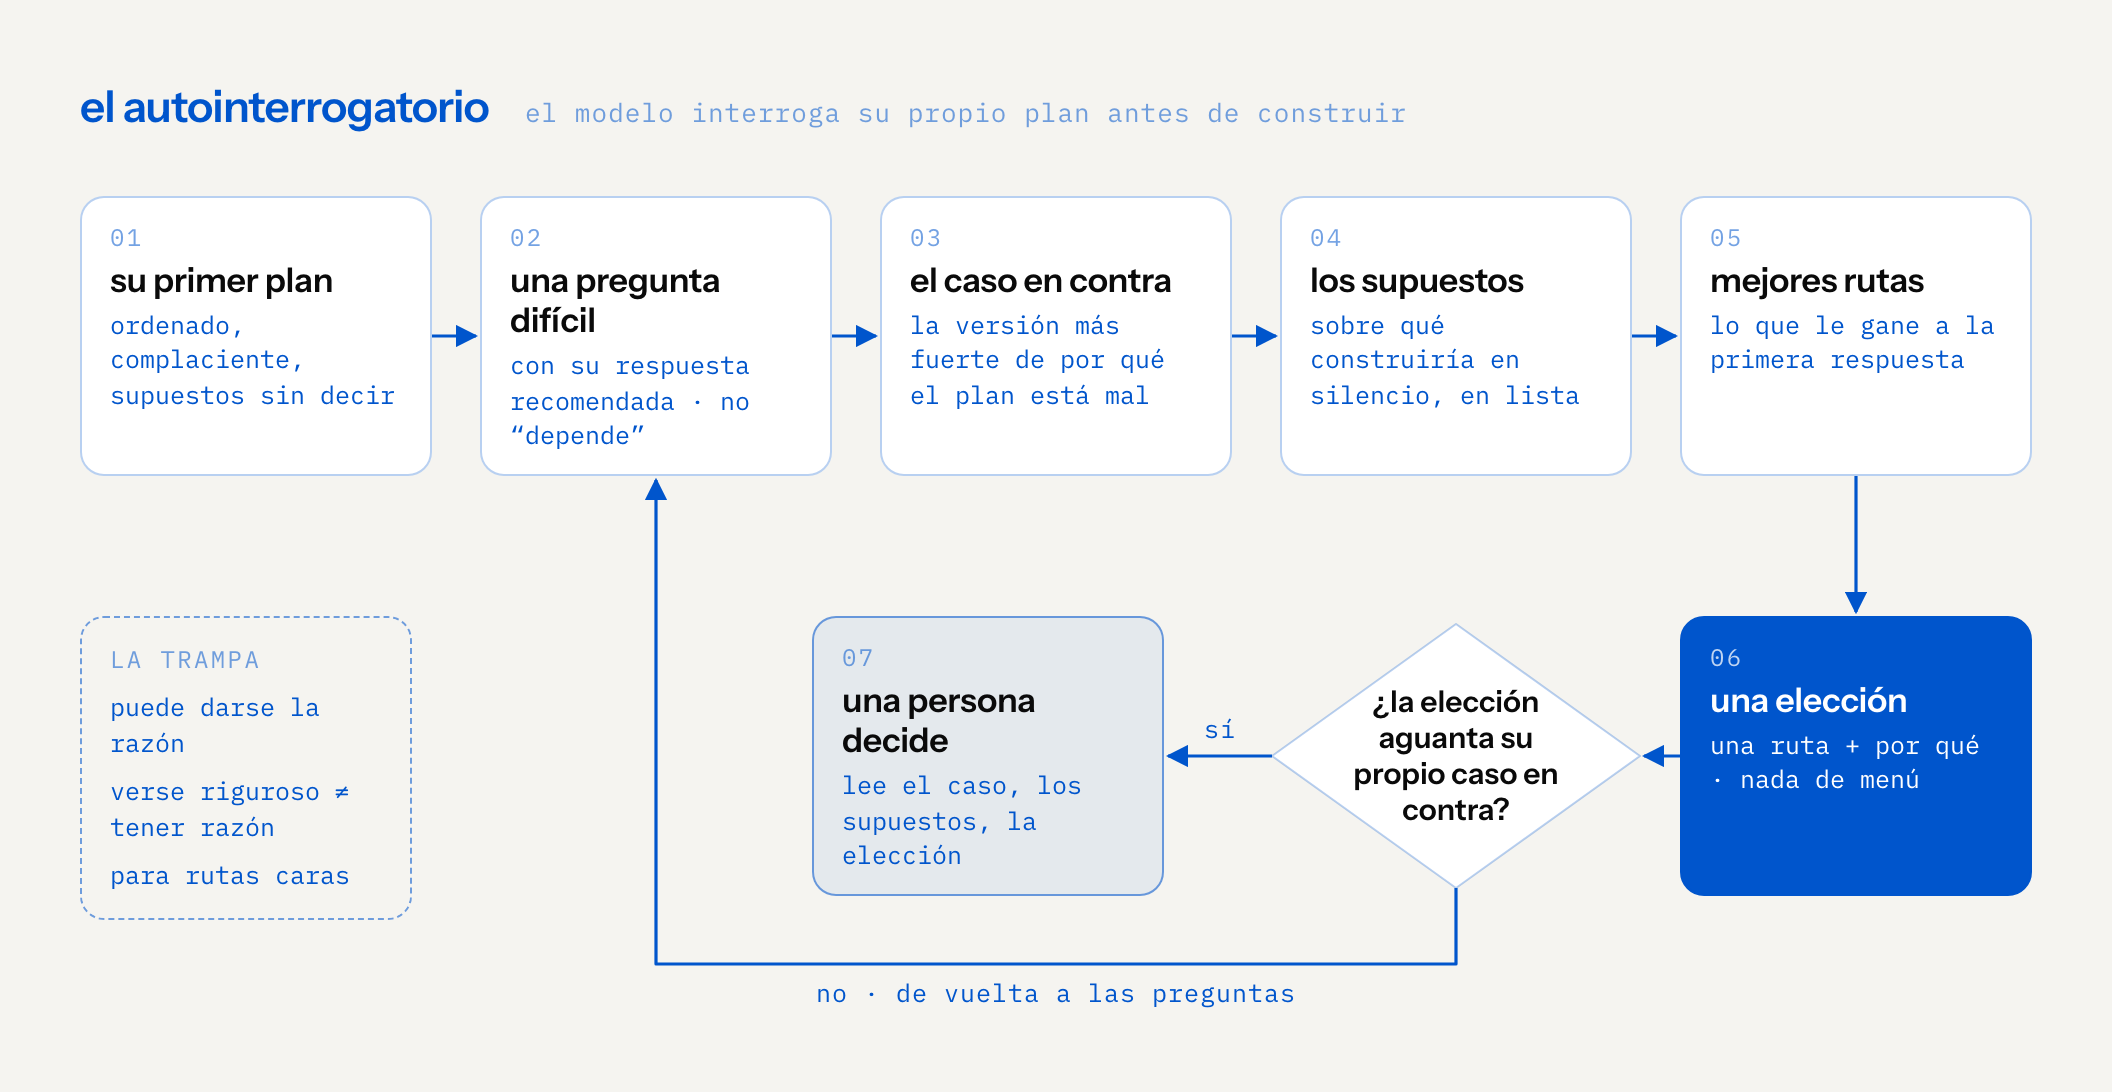
La última regla es la que más pesa. Un modelo que se interroga a sí mismo y después te devuelve tres opciones hizo la mitad del trabajo. Tener opinión es el entregable: esta es la ruta, por esto, y esto me haría cambiar de idea. Igual podés decir que no. Pero ahora estás reaccionando a una postura, y como en la entrevista, el no que sentís es información.
el orden depende de qué tan seguro estés
Los dos métodos no compiten. Son dos mitades, y cuál va primero depende de una pregunta: ¿qué tan seguro estás de lo que estás construyendo?
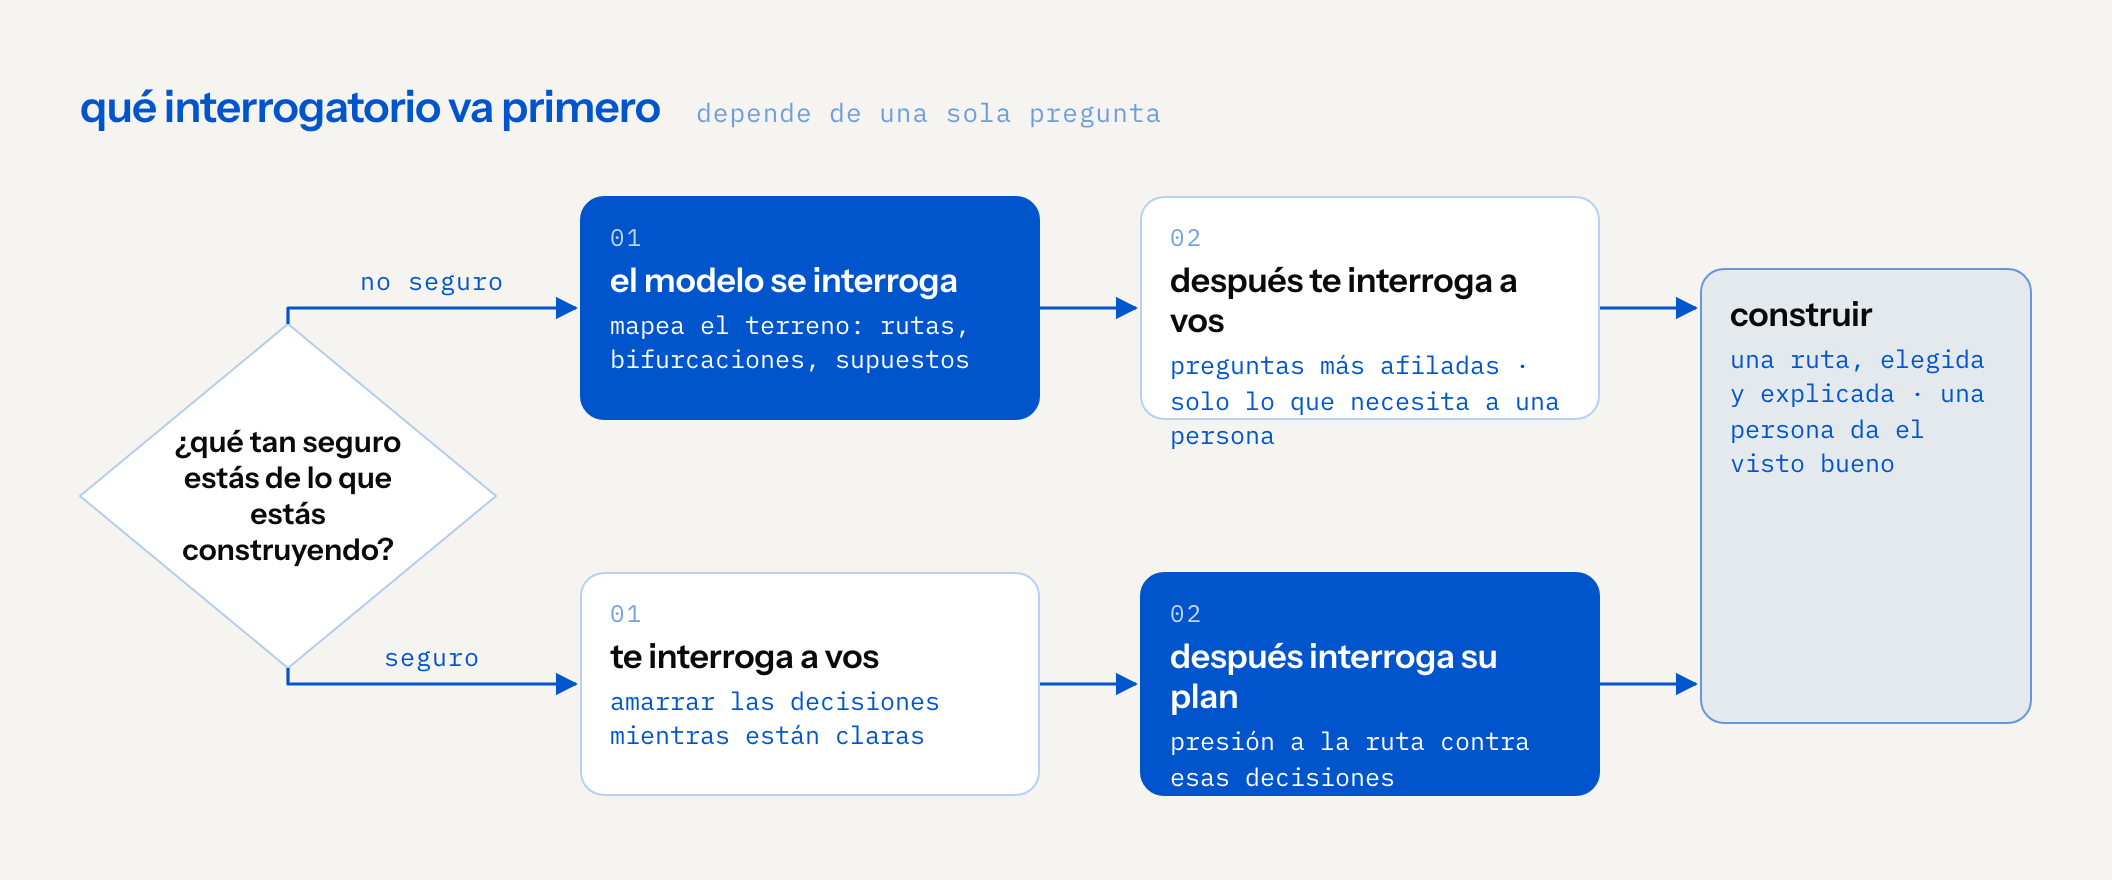
Cuando no estás seguro, el modelo se interroga primero. Mapea el terreno: las rutas, las bifurcaciones, los supuestos escondidos debajo de cada una. Después se da vuelta y te interroga a vos, y las preguntas salen más afiladas, porque ya sabe qué bifurcaciones de verdad importan y cuáles puede resolver por su cuenta. Tus respuestas se gastan en las decisiones que necesitan a una persona.
Cuando estás seguro, primero te interroga a vos, para amarrar las decisiones mientras las tenés claras. Después interroga su propio plan contra esas decisiones, para ponerle presión a la ruta antes de escribir una sola línea. Las decisiones son tuyas; la ruta igual tiene que aguantar el interrogatorio.
Lo hemos usado más que todo en el primer caso: cosas de las que no estábamos seguros, donde todavía no podríamos haber escrito un buen brief. Funcionó, y mejor de lo que esperábamos. No lo hemos medido, así que tomalo como una impresión, no como un resultado.
la trampa
- Puede simplemente darse la razón. Un modelo al que le pedís que argumente contra su propio plan puede escribir una objeción floja y después descartarla con educación. Eso es actuar la duda, no dudar. La misma razón por la que no dejamos que un agente califique su propia tarea aplica aquí: la autorrevisión agarra algunas cosas, y no puede ser el último control.
- Quema tokens. Cada pregunta es un turno, cada caso en contra es texto. En una tarea chica y obvia, el interrogatorio cuesta más de lo que ahorra. Lo guardamos para trabajo donde una ruta equivocada sale cara.
- Puede verse riguroso sin tener razón. Una lista numerada de preguntas difíciles con respuestas seguras se lee como diligencia. Vale lo que vale el material que tiene el modelo. Si la restricción real no está frente a él, se va a interrogar a fondo sobre las cosas equivocadas.
- Una persona sigue decidiendo. La elección es una recomendación. El modelo puede tener opinión; no puede hacerse responsable. Alguien que conoce el trabajo lee el caso en contra, los supuestos y la elección, y dice que sí o que no.
preguntas abiertas
Todavía no sabemos dónde deja de rendir el autointerrogatorio. Algunos planes mejoran después de una ronda y empeoran después de tres, cuando el modelo empieza a inventar problemas para tener algo que responder. Tampoco sabemos cuánto de esto aguanta con un modelo más débil, ni si debería ser un segundo modelo, aparte, el que haga el interrogatorio. Eso es lo siguiente que queremos probar.
relacionado
- Dejá que la IA te entreviste: la primera mitad del método, y el
/grill-mede Matt Pocock, de donde viene. - No podés dejar que un agente califique su propia tarea: por qué un modelo revisándose a sí mismo sirve y nunca alcanza.
- Construir por acumulación: el mismo instinto en lo visual, reaccionar a algo que tenés enfrente en vez de a una especificación.